1. Analysefunktionen im Überblick
In STDF V4 Datalogs aus der Halbleiter-Massenproduktion werden tausende parametrische Tests (PTR, MPR) und hunderttausende Chips (PRR) aufgezeichnet. Das bloße Einhalten von Spezifikationsgrenzen (LL/HL) sagt jedoch nichts darüber aus, ob der Fertigungsprozess stabil läuft, ob die Messwerte verlässlich sind oder ob sich unter den Gutteilen potenziell fehlerhafte Risikobauteile verbergen.
DLOG bietet spezialisierte Analyseansichten, um genau diese Fragen fundiert zu beantworten. Dieser Leitfaden beschreibt die Ansichten für Prozessfähigkeit, Ausreißer-Screening und Prüfmittelfähigkeit im Detail.
 Klicken zum Vergrößern
| Analysemodul | DLOG-Ansicht | Kernkennzahlen | Einsatzbereich |
|---|---|---|---|
| PAT+ Ausreißer-Screening | Wafer (PAT Data / PAT+), Chart (DPAT-Bänder) | DPAT-Bänder, SPAT-Nachbarschaftsresiduen, PAT+ Flips | Aussortieren verdächtiger Dies innerhalb der Gutteil-Spezifikation bei statistischer Abweichung |
| Multivariate Ausreißer | MVA Explorer, Wafer (MVA-PAT) | Mahalanobis MD², PCA SPE, Isolation Forest | Auffinden von Bauteilen, deren Einzeltests innerhalb der Limits liegen, deren Kombination aber anomal ist |
| Gauge R&R | Gauge R&R | EV, AV, PV, %GRR, %P/T, ndc | Wiederholgenauigkeit und Vergleichbarkeit des Messsystems anhand von Wiederholungsmessungen prüfen |
| Multi-Site-Kanalabweichung | SITE, Group Analysis (Group by: Site) | Site-Yield, BIN-Verteilung, Mittelwerte, η², ANOVA | Prüfen, ob eine Nadel der Nadelkarte oder ein Sockelkanal systematisch verschoben ist |
| Prozessfähigkeit | Chart, Dashboard, Group Analysis | Cpk, Cp, Est ppm, Normalität (Anderson-Darling) | Toleranzausnutzung quantifizieren, ppm-Fehlerraten schätzen und Normalverteilungsvoraussetzung prüfen |
| Korrelation & TTO | Correlation, TTO Engine | Pearson r, Spearman ρ, redundante Testkandidaten | Identifizieren redundanter Doppeltests zur fundierten Reduzierung der Testzeit |
Mittelwert und Standardabweichung werden mit dem numerisch stabilen Welford-Online-Algorithmus berechnet. Dies verhindert den Verlust signifikanter Stellen (katastrophale Auslöschung) bei der fortlaufenden Aufsummierung von Quadraten:
2. PAT+ Ausreißer-Screening (DPAT · SPAT)
PAT (Part Average Testing) ist im Automobil-Qualitätsstandard AEC-Q001 definiert. Ziel ist es, Bauteile auszusondern, die zwar die statischen Spezifikationsgrenzen einhalten, aber signifikant von der Normalverteilung der Gesamtheit abweichen, um Frühausfälle im Feld (Infant Mortality) zu minimieren.
DLOG berechnet im Modus PAT Data der Wafer-Ansicht die dynamischen PAT-Grenzwerte (PAT LL / HL). Wird in den Einstellungen PAT+ aktiviert, markiert DLOG verdächtige Dies nach DPAT- oder SPAT-Kriterien als visuelles Overlay direkt auf der Wafer-Map (die ursprüngliche Gut/Schlecht-Klassifizierung bleibt unberührt).
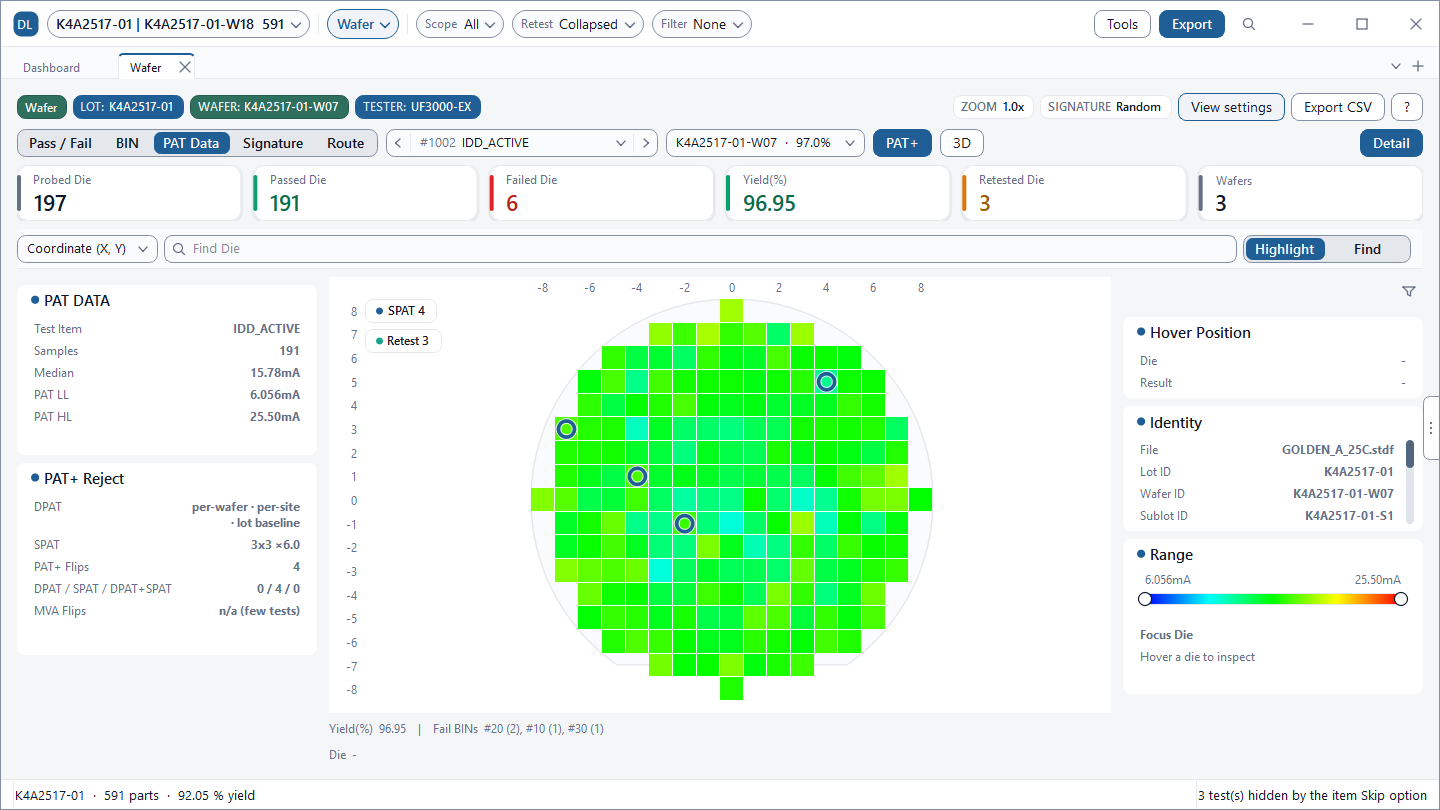 Klicken zum Vergrößern
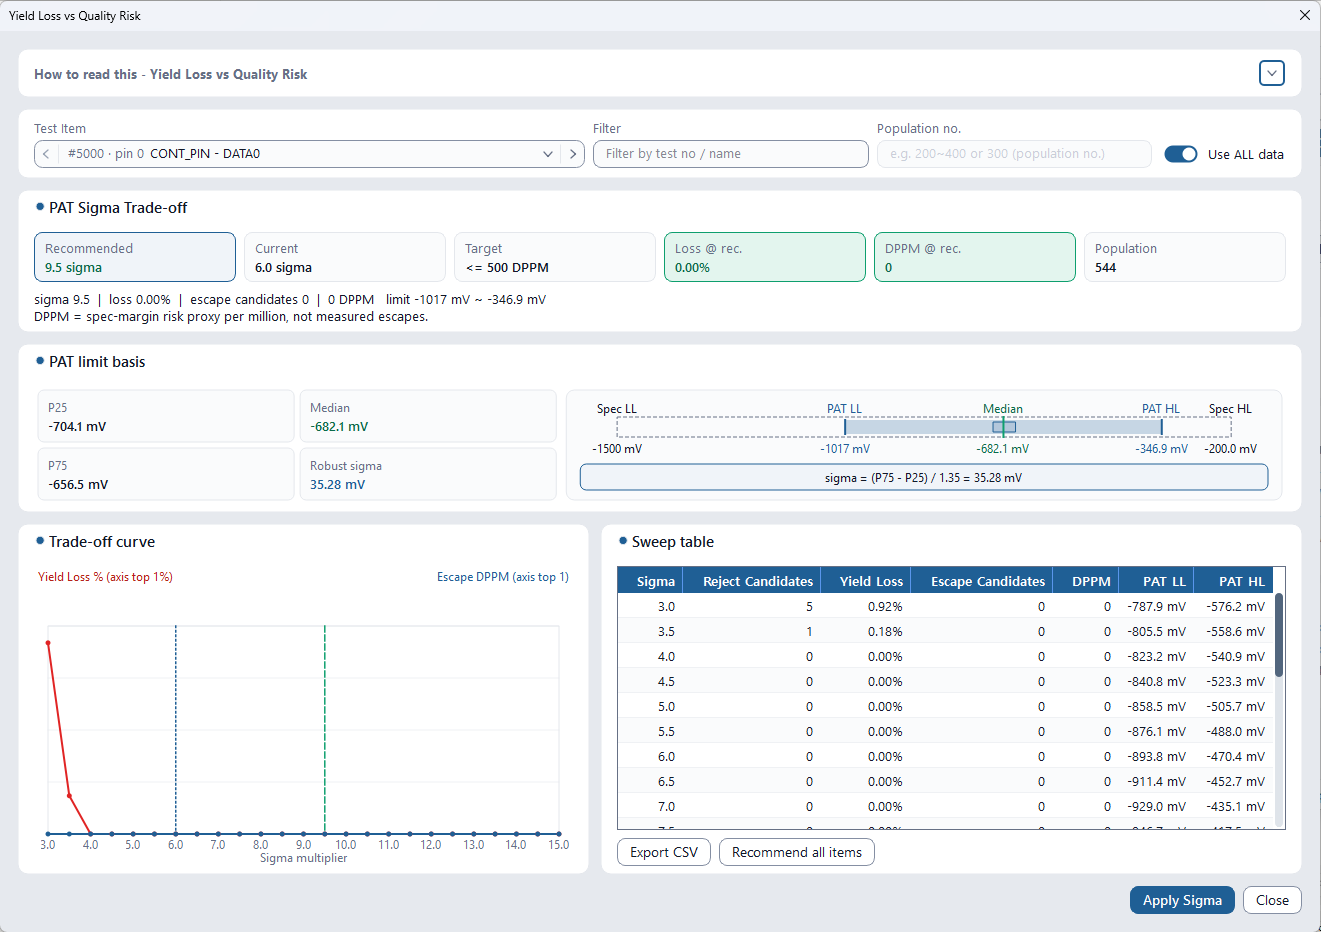 Klicken zum Vergrößern
DPAT: Robuste Grenzwerte aus den laufenden Daten
Um zu verhindern, dass extreme Ausreißer Mittelwert und Standardabweichung verzerren, nutzt DLOG den Median und ein aus dem Interquartilsabstand (IQR) geschätztes robustes Sigma:
Außerhalb dieses Fensters liegende Dies gelten als Ausreißerkandidaten. Der Standard-Multiplikator k ist 6. Über View settings > Wafer View Options > Lower Sigma (L) / Upper Sigma (H) können Unter- und Obergrenze unabhängig konfiguriert werden.
DPAT (Dynamisches PAT) passt diese Grenzen dynamisch pro Wafer, pro Test-Site oder pro Lot-Baseline an. Bei Site-Offsets korrigiert Site-DPAT Hardware-Verschiebungen; Lot-DPAT eignet sich zur Verfolgung von Wafer-zu-Wafer-Drifts. Im Chart-Trend können diese Grenzen via DPAT (trend) über die Messreihenfolge gelegt werden.
SPAT: Räumliche Nachbarschafts-Residuen
Lokale Defektmuster (Kratzer, Kantenanhäufungen, Mikrocluster) fallen in der Gesamtverteilung oft nicht auf. SPAT (Spatial PAT) vergleicht das Ziel-Die $(i, j)$ mit dem Median der umliegenden PASS-Dies im Verhältnis zum robusten Sigma der Nachbarschaft:
Der Standard-Kernel beträgt $3 \times 3$ mit Multiplikator 6.0. An Waferrändern oder in dichten Defektzonen mit wenigen PASS-Nachbarn erweitert DLOG den Kernel automatisch um bis zu 2 konzentrische Ringe nach außen.
PAT-Sigma festlegen: Yield Loss vs. Quality Risk
Ein strengeres k fängt mehr Risikodies ein, erhöht jedoch den Ausbeuteverlust (Overkill) bei intakten Bauteilen. Unter Tools > Studies > Yield Loss vs Quality Risk visualisiert DLOG Kurven für Reject Candidates, Yield Loss und DPPM und schlägt das optimale Sigma für ein Ziel-DPPM vor. Ein Klick auf Apply Sigma übernimmt den Wert sofort.
3. MVA Explorer (Multivariate Ausreißer)
Zusammengehörige Parameter korrelieren in der Regel. Wenn bei einem Bauteil Test A und Test B einzeln betrachtet im Limit liegen, jedoch Test A ungewöhnlich hoch und Test B ungewöhnlich niedrig ist, weicht die Kombination drastisch vom physikalischen Normalmuster ab. Der MVA Explorer spürt solche mehrdimensionalen Ausreißer zuverlässig auf.
 Klicken zum Vergrößern
Drei Erkennungsalgorithmen
| Algorithmus | Funktionsweise | Empfohlener Einsatz |
|---|---|---|
| Mahalanobis (MD²) | Statistische Distanz unter Berücksichtigung der Kovarianz. Kennzeichnung bei Überschreitung der Chi-Quadrat-Schwelle. | Standardempfehlung für die meisten Datensätze |
| PCA reconstruction (SPE) | Hoher Rekonstruktionsfehler (Q-Statistik) bei Rückprojektion aus Hauptkomponenten. Erkennt Korrelationsbrüche. | Große Testanzahl mit hoher Korrelation |
| Isolation Forest | Verteilungsfreier Baum-Algorithmus zur Erkennung leicht isolierbarer Punkte. Markiert die obersten ~1% der PASS-Teile. | Nichtlineare und multimodale Muster |
Mahalanobis-Distanz (MD²)
Euklidische Distanzen ignorieren Skalierungsunterschiede und Korrelationen. Die Mahalanobis-Distanz korrigiert dies über die inverse Kovarianzmatrix ($\mathbf{\Sigma}$). DLOG zerlegt den Beitrag jedes Tests in $z_i \cdot (\mathbf{\Sigma}^{-1}\mathbf{z})_i$, sodass die Summe exakt $MD^2$ ergibt:
Der Schwellenwert Threshold (Sigma) (3.0 bis 6.0σ, Standard 6.0σ) wird in die zweiseitige Normalwahrscheinlichkeit $\alpha$ umgerechnet und bestimmt den kritischen Chi-Quadrat-Wert für $r$ Freiheitsgrade (Anzahl der Tests). Bei PCA bildet der Rekonstruktionsfehler SPE (Squared Prediction Error) den Maßstab.
Ergebnistabelle interpretieren
| Spalte | Bedeutung |
|---|---|
| Status | OUTLIER · NORMAL · NOT SCORED (fehlende Werte bei ausgewählten Tests) · EXCLUDED (nicht PASS) |
| Score | Ausreißer-Score des gewählten Algorithmus (MD², SPE oder Isolation Forest) |
| Risk | Score ÷ Threshold. Werte über 1.0x bedeuten OUTLIER |
| Top contributor | Testparameter mit dem größten Beitrag zum Score samt robustem z-Score (auf Basis von Median und MAD) |
max(50, 5 × Testanzahl) betragen (in Abb. 3 bei 15 Tests also mind. 75 Teile). Wählen Sie physikalisch korrelierte Parameter. Im MVA-PAT Modus der Wafer-Ansicht können diese Scores ortsaufgelöst betrachtet und MVA-Flips als CSV exportiert werden.
4. Gauge R&R Messsystemanalyse
Die gemessene Gesamtstreuung setzt sich aus der echten Produktstreuung und der Messunsicherheit des Testsystems (Tester, Nadelkarte, Sockelkontaktierung) zusammen:
Eine zu hohe Messstreuung führt zu teurem Scheinausschuss oder gefährlichem Kundenschlupf. Die Ansicht Gauge R&R zerlegt diese Varianz anhand mehrfach gemessener STDF-Datalogs desselben Wafers. DLOG ordnet die Dies über ihre (X, Y)-Koordinaten zu, sodass auch Dateien mit abweichender Lot-/Wafer-ID problemlos als Messwiederholungen verglichen werden können.
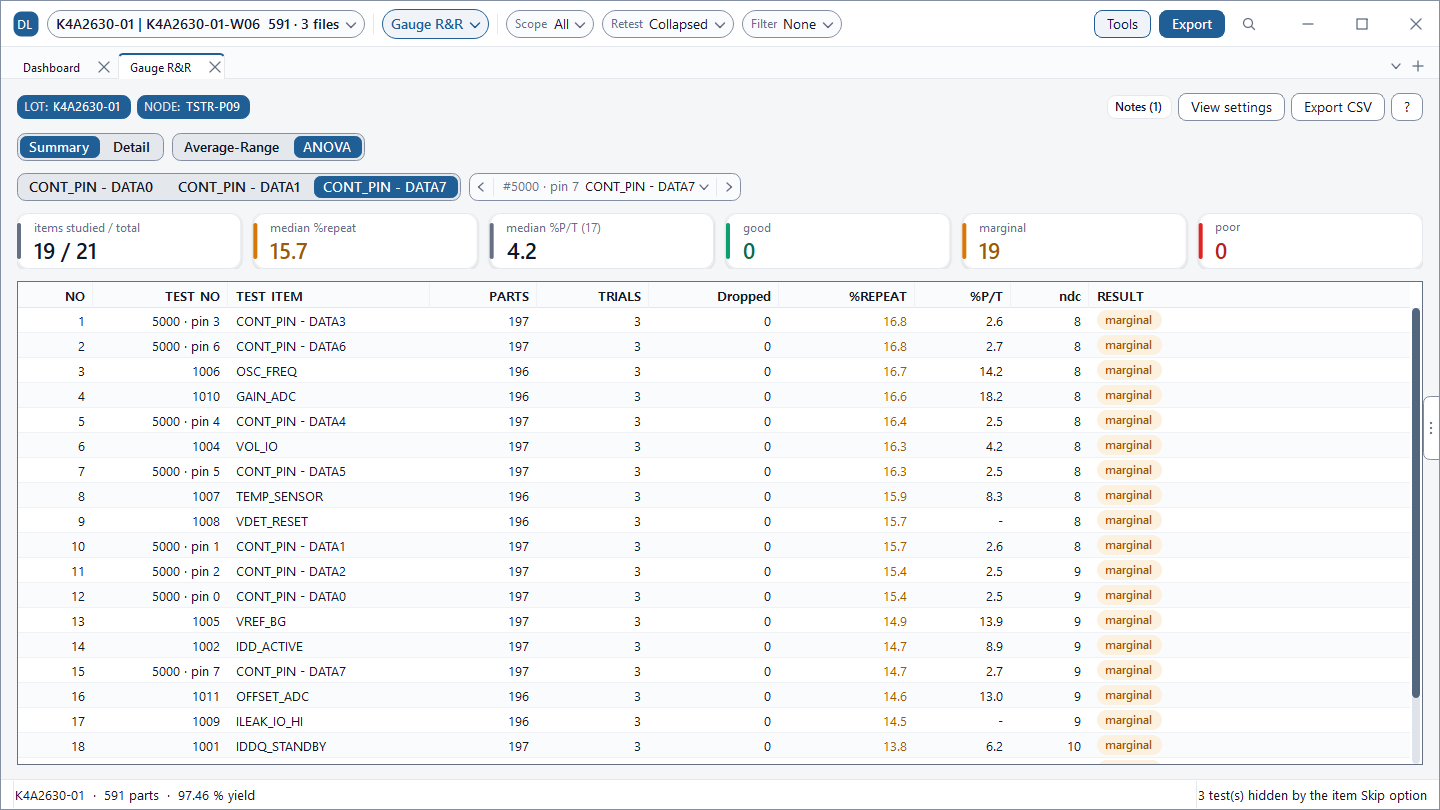 Klicken zum Vergrößern
Streuungskomponenten und Methoden
| Komponente | Bedeutung |
|---|---|
| EV (Wiederholbarkeit) Equipment Variation | Streuung bei wiederholter Messung unter identischen Bedingungen (Grundrauschen des Testers). |
| AV (Vergleichbarkeit) Appraiser Variation | Schwankungen zwischen verschiedenen Dateien, Durchläufen oder Test-Sites (Sockelkontaktierung, Drift). |
| GRR | $\sqrt{EV^2 + AV^2}$ — Gesamte vom Messsystem erzeugte Streuung. |
| PV | Echte Bauteilstreuung über den Wafer hinweg (Prozessvariation). |
Als Rechenmethode stehen ANOVA (Standard, Schätzung der Varianzkomponenten über mittlere Quadrate) und Average-Range (AIAG-Formelblatt über Spannen und $d_2$-Faktoren) zur Auswahl. Bei großen Stichproben liefert ANOVA signifikant stabilere Ergebnisse. Modi: Nur Wiederholbarkeit (Einzelsite, AV entfällt) oder Cross-Site (Sites fungieren als Prüfer).
%GRR-Kriterien und ndc
| %GRR | Urteil | Bewertung |
|---|---|---|
| < 10% | good | Messsystem voll fähig. Bei ndc ≥ 5 ist auch die Auflösung exzellent. |
| 10% bis 30% | marginal | Bedingt akzeptabel, abhängig von Prüfaufwand, Bauteilkosten und Risikoklasse. |
| > 30% | poor | Messunsicherheit dominiert die Entscheidung. Nadelkontaktierung, Sockel und DIB prüfen. |
5. Multi-Site Hardware-Delta-Analyse
Beim parallelen Testen auf mehreren Sites führen Nadeldruckdifferenzen, Sockelübergangswiderstände oder Relaisalterung häufig dazu, dass einzelne Testkanäle systematisch abdriften. Die Ansicht SITE vergleicht Ausbeute, BIN-Struktur und Messwertmittelwerte, um fehlerhafte Hardware-Kanäle sofort zu isolieren.
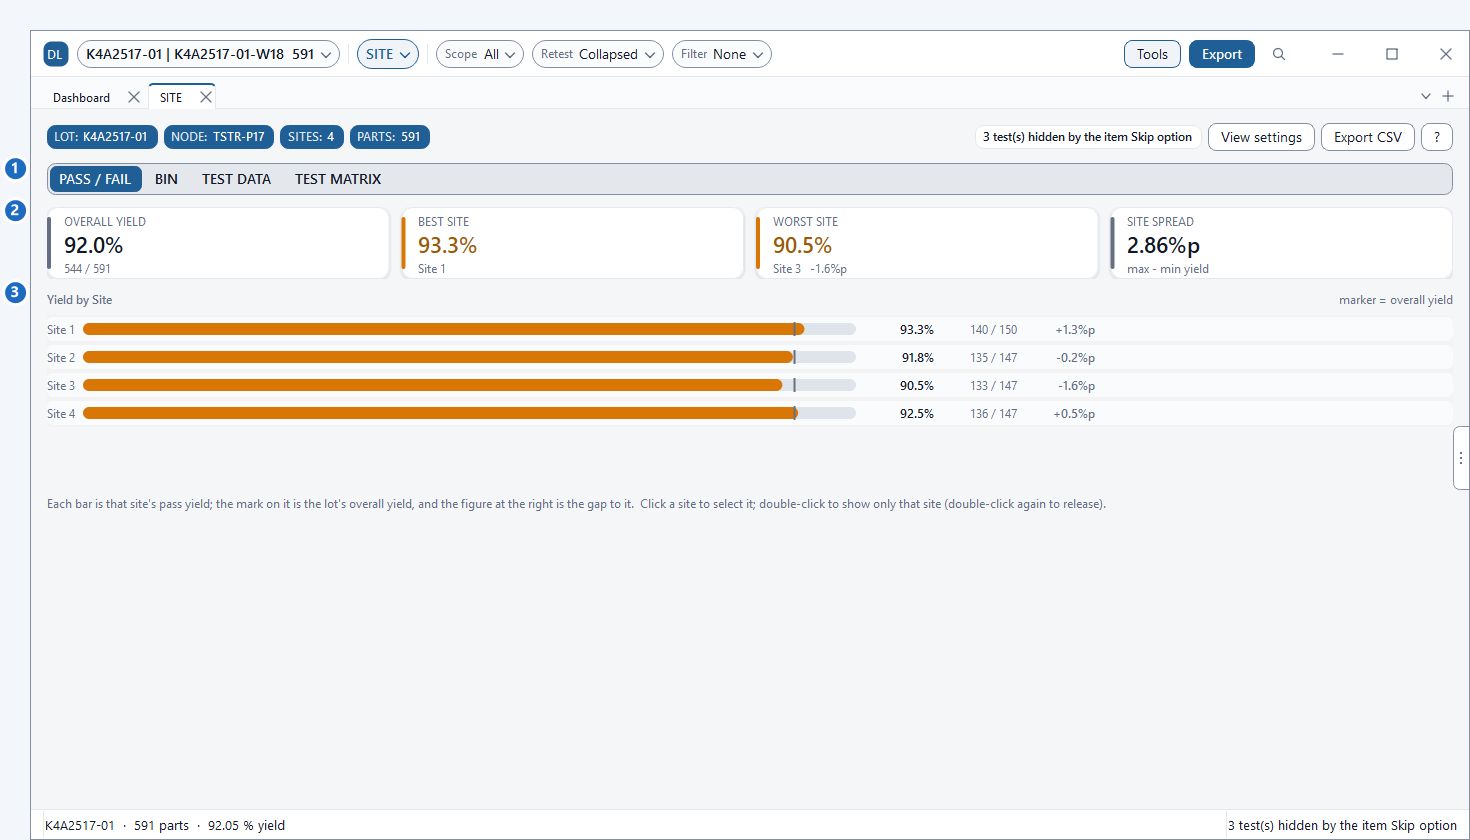 Klicken zum Vergrößern
| Prüfpunkt | Ansicht | Diagnoseweg |
|---|---|---|
| Niedrigste Ausbeute | SITE > PASS / FAIL | Kürzester Balken; wird auch in der WORST SITE Karte benannt |
| Häufung spezifischer Fehler | SITE > BIN | Prüfen, ob bestimmte Fail-BINs konzentriert auf einer Site auftreten |
| Verschobene Messwerte | SITE > TEST DATA | Abweichung des Site-spezifischen PASS-Mittelwerts vom Gesamtwert (Δ vs overall) |
| Site-dominierte Tests | SITE > TEST MATRIX | η² (Anteil der Streuung durch Site-Effekt). Unter 5% Einfluss wird mit - dargestellt |
| Statistische Signifikanz | Group Analysis (Group by: Site) | One-way ANOVA p-Wert und paarweise Tukey HSD Kontraste |
| Messwiederholbarkeit | Gauge R&R (Cross-Site) | Quantifizierung der AV-Komponente bei Vermessung identischer Bauteile auf allen Sites |
6. Cpk · Cp · Est ppm · Normalität
Prozessfähigkeitsindizes quantifizieren, wie viel Sicherheitsabstand die reale Verteilung zu den Spezifikationsgrenzen (LL/HL) einhält. DLOG weist Cpk und Cp in den Test Item Statistics von Chart, in der Liste Tests (Cpk) und im Dashboard in Echtzeit aus.
Hierbei stehen $\mu$ und $\sigma$ für Mittelwert und Standardabweichung des aktuellen Filters (Scope). Est ppm entspricht der theoretischen zweiseitigen Randwahrscheinlichkeit unter Normalverteilungsannahme. Dashboard-Einstufung: Kritisch (< 1.00), Akzeptabel (1.00 bis 1.33) und Gut (≥ 1.33), konfigurierbar in den Optionen.
| Cpk | Sigma-Niveau | Theoretische Fehlerrate (Normalverteilung) | Praxisbezug |
|---|---|---|---|
1.00 | $3\sigma$ | ca. 2.700 ppm | Mittelwert zentriert, 3σ Abstand zur Toleranzgrenze |
1.33 | $4\sigma$ | ca. 63 ppm | Industrieller Standard-Mindestwert für stabile Prozesse |
1.50 | $4.5\sigma$ | ca. 6.8 ppm | Gute Prozesskontrolle in Halbleiter-Linien |
1.67 | $5\sigma$ | ca. 0.57 ppm | Üblicher Richtwert für Automotive und sicherheitskritische ICs |
2.00 | $6\sigma$ | ca. 0.002 ppm | Six-Sigma-Qualitätsziel |
Die Tabellenwerte gelten bei zentrierter Lage und idealer Normalverteilung. Verbindlich sind stets die vertraglich vereinbarten Kundenvorgaben.
Normalitätsprüfung und CDF / Wahrscheinlichkeitsnetz
Cpk und Est ppm besitzen nur dann Aussagekraft, wenn die Daten tatsächlich einer Gaußschen Normalverteilung folgen. DLOG berechnet den auf Ausreißer in den Verteilungsenden hochsensiblen Anderson-Darling Test (p-Wert als Normality (AD)). Bei p < 0.05 liegt signifikante Nicht-Normalität vor.
 Klicken zum Vergrößern
7. Korrelationsanalyse · ANOVA · TTO
Fehlerursachen im Halbleitertest liegen selten in isolierten Parametern, sondern zeigen sich in Wechselwirkungen mehrerer Tests oder spezifischen Gruppierungen (Site, Temperatur, Lot, Datei). Correlation deckt das gemeinsame Verhalten auf, während Group Analysis Gruppenunterschiede auf statistische Signifikanz prüft.
 Klicken zum Vergrößern
 Klicken zum Vergrößern
Pearson- und Spearman-Korrelation
Pearson erfasst lineare Zusammenhänge; die rangbasierte Spearman-Korrelation ist unempfindlich gegenüber Ausreißern und erkennt auch nichtlineare monotone Zusammenhänge. Die Sortierung Cluster gruppiert korrelierte Parameter zu gut sichtbaren Blöcken. Über Auto isoliert DLOG Tests mit starker Korrelation (|r| ≥ 0.70).
Einfaktorielle Varianzanalyse (One-way ANOVA)
Group Analysis unterteilt Testergebnisse nach Site, File, Corner, Temp, Process, Node, Program-Rev oder Product und berechnet, ob sich Gruppenmittelwerte statistisch signifikant unterscheiden:
- p-Wert < 0.05: Unter der Annahme identischer Gruppenmittelwerte liegt die Wahrscheinlichkeit für die beobachtete Differenz unter 5%. Mindestens eine Gruppe unterscheidet sich signifikant.
- Eta² (η²): Effektstärke – Anteil der Gesamtvarianz, der auf Gruppeneffekte zurückzuführen ist. Nahe 0 bedeutet keinen Gruppeneinfluss; 0.40 bedeutet, dass 40% der Streuung durch Gruppenunterschiede erklärt werden.
- Tukey HSD: Paarweiser Mittelwertvergleich nennt die genaue Anzahl abweichender Paare (z. B. „0 of 6 pairs differ“).
Im Beispiel in Abb. 7-2 zeigt Eta² von 0.001 und ein p-Wert von 0.6772, dass keine signifikanten Unterschiede zwischen den Sites vorliegen. Der grüne Chip No difference signalisiert dies auf einen Blick.
8. Prozessdrift vs. Messunsicherheit unterscheiden
Fällt der Cpk ab oder bricht die Ausbeute ein, verdächtigt das Fab-Team oft das Testequipment, während das Testteam die Ursache im Waferprozess vermutet. Mit den Analysewerkzeugen von DLOG lassen sich beide Ursachen datenbasiert abgrenzen:
| Prüfbereich | Ursache im Waferprozess (Fab) | Ursache im Testequipment / Messaufbau |
|---|---|---|
| Räumliche Verteilung (Wafer > Signature) |
Konzentrische Ringe, Randausfälle, Zentrumsmuster, lokale Fehlercluster | Geringe Ausbeute bei Cluster-Score nahe 0 (rein zufällig), Periodizität nach Belichtungsfeld oder Sites |
| Multi-Site-Verhalten (SITE, Group Analysis) |
Gleichförmige Verteilung über alle Testkanäle | Einzelne Site weicht stark ab, Group ANOVA p-Wert hochsignifikant |
| Messwiederholbarkeit (Gauge R&R) |
%GRR niedrig, Bauteilstreuung (PV) dominiert | %GRR hoch, Equipment- (EV) oder Appraiser-Streuung (AV) dominiert |
| Trendverlauf (Chart > Trend) |
Sprunghafte Änderungen entlang von Wafer- oder Lotgrenzen | Kontinuierlicher Drift über die Testzeit, Verschiebung nach Wartung von Nadelkarte/Sockel |
| Maßnahmen | Fab-Anlagen und Prozessrezepte überprüfen (Lithografie, Ätzen, CMP) | Nadelkarte/Sockel reinigen oder tauschen, Kontaktierung und DIB-Masse prüfen |
9. Häufig gestellte Fragen (FAQ) & Berichte
Häufig gestellte Fragen (FAQ)
Cpk setzt eine univariat normalverteilte Eigenschaft voraus. Nicht-Normalverteilungen (z. B. bimodale Verläufe) oder mehrdimensionale Testkombinationen, die physikalische Zusammenhänge verletzen, werden vom skalaren Cpk nicht erkannt. Setzen Sie PAT+ (DPAT · SPAT) und MVA (MVA Explorer, Wafer MVA-PAT) ein, um Ausreißer im Gutteilbereich zu erfassen.
Prüfen Sie die Varianzkomponenten im Detail-Fenster von Gauge R&R. Wenn EV überwiegt, analysieren Sie Tester-Rauschen, Erdung, Ripple auf den Spannungsversorgungen und Abschirmungen. Überwiegt AV, prüfen Sie Unterschiede zwischen Dateien oder Sites (Sockelabnutzung, Nadelandruck, Kalibrierung).
Sie benötigen mindestens 2 STDF-Dateien von wiederholten Messungen desselben Wafers mit vollständigen (X, Y)-Koordinaten. Fügen Sie Wiederholungsmessungen über Append... hinzu. Datalogs ohne Koordinaten (z. B. FT) können nicht abgeglichen werden.
Ja. In jeder Ansicht können Daten über Export CSV gesichert werden. Über Export > Save Report erzeugen Sie vollständige Berichte als PDF, Excel (.xlsx), Word (.docx) oder Grafik. PAT-Grenzdiagramme lassen sich über PAT (PDF) als einseitige Berichte pro Parameter exportieren.
Überprüfen Sie Prozessfähigkeit und Messsystem-Zuverlässigkeit mit DLOG
PAT+ Ausreißer-Screening, MVA Explorer, Gauge R&R, Multi-Site-Varianz und Cpk-Fähigkeitsstatistiken.
Testen Sie die STDF-Tiefenanalyse in einer 100%igen Offline-Umgebung 6 Monate lang kostenlos.