1. 분석 기능 한눈에 보기
반도체 양산 테스트 데이터인 STDF V4 데이터로그에는 수천 개의 파라메트릭 테스트(PTR, MPR)와 수십만 개 이상의 파트(PRR)가 기록됩니다. 스펙 한계(LL/HL) 안에 들어온 합격품만으로는 공정이 안정적인지, 측정 자체를 믿어도 되는지, 합격품 중에 위험한 파트가 섞여 있는지를 알 수 없습니다.
DLOG는 이런 질문에 답하는 분석 화면을 갖추고 있습니다. 화면 상단의 뷰 선택 메뉴에서 열 수 있으며, 이 페이지는 그중 공정능력과 이상치·측정 신뢰도 분석에 쓰이는 화면들을 설명합니다.
 클릭하여 확대
| 분석 | DLOG 화면 | 핵심 지표 | 이럴 때 씁니다 |
|---|---|---|---|
| PAT+ 이상치 선별 | Wafer (PAT Data / PAT+), Chart (DPAT 밴드) | DPAT 밴드, SPAT 이웃 잔차, PAT+ Flips | 스펙 한계 내에 있으나 전체 분포 또는 인접 다이 대비 이상치를 보이는 의심 다이(Maverick Die) 선별 |
| 다변량 이상치 | MVA Explorer, Wafer (MVA-PAT) | Mahalanobis MD², PCA SPE, Isolation Forest | 개별 테스트 항목은 규격 내에 있으나 다변량 상관관계가 정상 군집에서 벗어난 잠재 불량 디바이스 검출 |
| Gauge R&R | Gauge R&R | EV, AV, PV, %GRR, %P/T, ndc | 같은 웨이퍼를 반복 측정한 데이터로 측정 시스템의 신뢰도 평가 |
| 사이트 편차 | SITE, Group Analysis (Group by: Site) | 사이트별 수율 · BIN · 평균, η², ANOVA | 프로브카드 · 소켓 한 칸만 이상한지 확인 |
| 공정능력 | Chart, Dashboard, Group Analysis | Cpk, Cp, Est ppm, Normality (Anderson-Darling) | 한계 대비 여유와 불량률 추정, 정규분포 가정이 맞는지 점검 |
| 상관 · TTO | Correlation, TTO Engine | Pearson r, Spearman ρ, 중복 테스트 후보 | 같은 것을 재는 중복 테스트를 찾아 테스트 시간 단축 검토 |
평균과 표준편차는 값을 한 번 훑는 동안 갱신하는 Welford 온라인 방식으로 계산합니다. 제곱합을 단순 누적할 때 생기는 자리수 손실(Catastrophic Cancellation)을 피하는 수치 안정적인 방법입니다:
2. PAT+ 이상치 선별 (DPAT · SPAT)
PAT(Part Average Testing)는 자동차 전장용 반도체 품질 가이드라인인 AEC-Q001이 다루는 개념으로, 스펙 한계 안에 있더라도 같은 모집단의 정상 분포에서 크게 벗어난 파트를 걸러내어 잠재 불량(조기 고장)이 출하되는 것을 줄이려는 방법입니다.
DLOG는 Wafer 화면의 PAT Data 모드에서 선택한 테스트의 PAT 한계(PAT LL / HL)를 계산해 보여 주고, 설정에서 PAT+를 켜면 합격(PASS)이지만 DPAT 또는 SPAT 규칙으로 의심스러운 다이를 웨이퍼 맵 위에 겹쳐 표시합니다. 원래의 합부 판정은 바꾸지 않습니다.
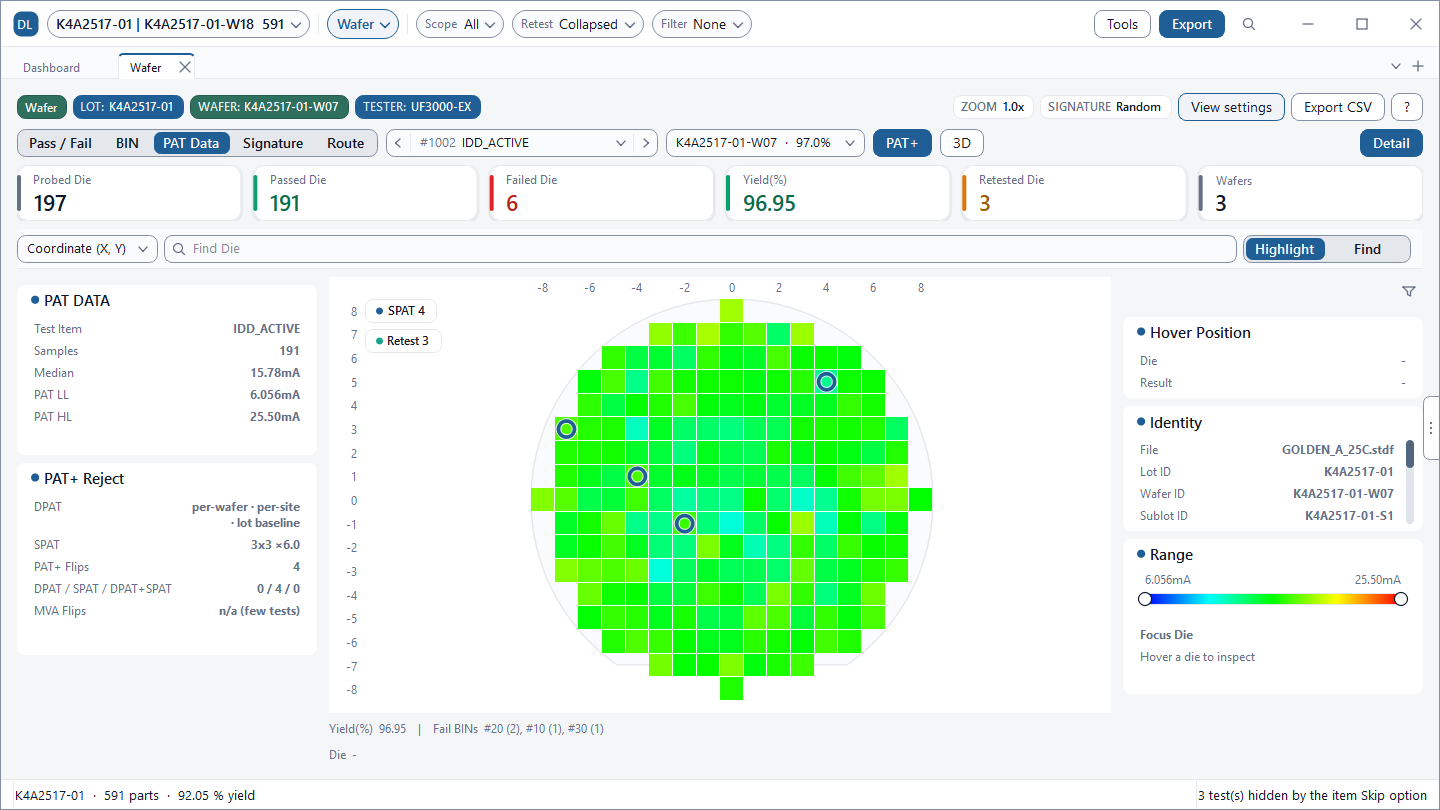 클릭하여 확대
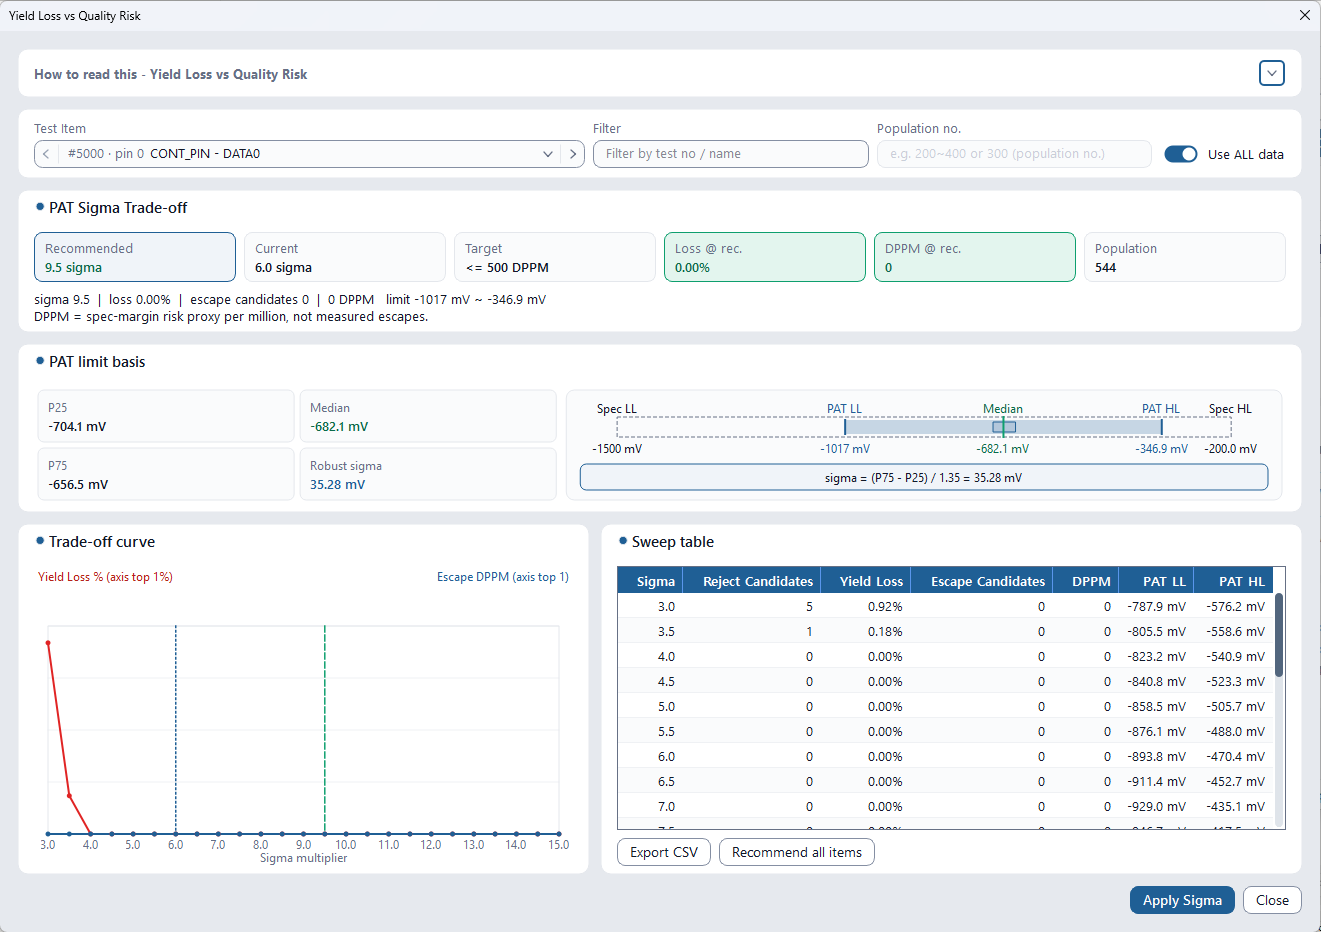 클릭하여 확대
DPAT: 로버스트 통계로 데이터에서 다시 계산하는 한계
이상치 자체가 평균과 표준편차를 끌어당기는 것을 막기 위해, DLOG는 평균 대신 중앙값을, 표준편차 대신 사분위 범위(IQR)로 추정한 로버스트 시그마를 사용합니다:
범위 밖의 다이가 이상치 후보입니다. 시그마 배수 k의 기본값은 6이며, View settings > Wafer View Options의 Lower Sigma (L) / Upper Sigma (H)에서 아래쪽과 위쪽을 따로 조절할 수 있습니다. k가 작을수록 더 많은 다이가 후보가 됩니다.
DPAT(Dynamic PAT)는 한계를 고정하지 않고 같은 계산을 웨이퍼별 · 사이트별 · 로트 기준으로 각각 다시 수행합니다. 사이트마다 측정 오프셋이 있으면 사이트별 DPAT가, 웨이퍼 간 드리프트를 보려면 로트 기준 DPAT가 적합합니다. 같은 밴드를 Chart의 Trend에서 DPAT (trend) 옵션으로 측정 순서 위에 겹쳐 볼 수도 있습니다.
SPAT: 이웃 다이와의 잔차
웨이퍼 전체 분포로는 보이지 않는 국소 이상(작은 불량 덩어리, 긁힘, 가장자리 쏠림)은 이웃과 비교해야 보입니다. SPAT는 대상 다이 $(i, j)$를 둘러싼 이웃 중 PASS 다이의 중앙값과의 차이(잔차)를 이웃들의 로버스트 시그마에 대해 평가합니다:
기본 커널은 $3 \times 3$이고 배수는 6.0입니다. 불량 다이가 몰린 가장자리에서는 PASS 이웃이 부족해지므로, 이웃이 최소 개수에 못 미치면 커널을 바깥 링으로 최대 2단계까지 넓혀 비교합니다.
PAT 시그마, 얼마로 정할까: Yield Loss vs Quality Risk
k를 줄이면 더 많은 의심 다이를 잡지만 멀쩡한 다이를 버리는 수율 손실(Overkill)도 늘어납니다. Tools > Studies의 Yield Loss vs Quality Risk는 테스트별로 시그마를 훑으며 Reject Candidates, Yield Loss, DPPM을 표와 곡선으로 보여 주고, 목표 DPPM을 만족하는 권장 시그마를 제안합니다. 마음에 들면 Apply Sigma로 적용합니다.
3. MVA 탐색기 (다변량 이상치)
관련된 테스트들은 보통 함께 움직입니다. 어떤 파트는 테스트 A도 B도 각각 정상 범위인데 A는 높고 B는 낮아 둘의 관계가 평소와 다르다면, 하나씩 볼 때는 합격이지만 조합으로 보면 이상치입니다. MVA 탐색기는 이런 파트를 찾습니다. (MVA = Multivariate Analysis)
 클릭하여 확대
세 가지 알고리즘
| 알고리즘 | 어떻게 찾나요 | 이럴 때 |
|---|---|---|
| Mahalanobis (MD²) | 테스트 간 상관을 고려한 통계적 거리. 카이제곱 분포 임계값을 넘으면 이상치 | 일반적인 기본 선택 |
| PCA reconstruction (SPE) | 주성분으로 복원했을 때 오차가 큰 파트. 정상 상관 패턴으로 설명되지 않는 파트 | 테스트 수가 많을 때 |
| Isolation Forest | 분포 가정 없이 남들과 쉽게 분리되는 파트. 임계치 대신 PASS 파트 상위 약 1%를 이상치로 판정 | 다른 두 방법이 놓치는 드문 조합 |
마할라노비스 거리 (Mahalanobis MD²)
유클리드 거리는 파라미터 간 상관과 단위 차이를 반영하지 못합니다. 마할라노비스 거리는 공분산 행렬($\mathbf{\Sigma}$)의 역행렬로 이를 보정합니다. DLOG는 로버스트하게 추정한 중심과 수축(shrinkage) 공분산을 사용하며, 각 테스트의 기여도는 $z_i \cdot (\mathbf{\Sigma}^{-1}\mathbf{z})_i$로 나누어 계산해 합이 $MD^2$가 되도록 합니다:
Threshold (Sigma) 설정(3.0 / 4.0 / 5.0 / 6.0σ, 기본 6.0σ)은 정규분포의 양측 확률 $\alpha$로 환산되어 자유도 $r$(사용한 테스트의 계수)의 카이제곱 임계값이 됩니다. 값이 클수록 엄격해 이상치 수가 줄어듭니다. PCA 방식의 SPE(재구성 오차, Q-통계량)는 주성분 모델이 설명하지 못하는 잔차 성분의 크기를 점수로 삼습니다.
결과 표 읽는 법
| 열 | 뜻 |
|---|---|
| Status | OUTLIER · NORMAL · NOT SCORED(선택 테스트 중 측정값이 빠진 파트) · EXCLUDED(PASS가 아닌 파트) |
| Score | 선택한 알고리즘의 이상치 점수 (MD², SPE, Isolation Forest 점수) |
| Risk | Score ÷ Threshold. 1.0x를 넘으면 OUTLIER |
| Top contributor | 점수를 가장 크게 끌어올린 테스트와 로버스트 z-점수(중앙값과 MAD 기준) |
max(50, 5 × 사용 테스트 수) 이상이어야 합니다(그림 3은 15개 테스트이므로 최소 75). 서로 관련 있는 파라메트릭 테스트를 고르세요. 관련 없는 항목이 많으면 이상치 점수가 흐려집니다. Wafer 화면의 MVA-PAT 모드에서는 같은 점수를 다이 위치별로 확인하고, PASS였다가 MVA 이상치가 된 다이(MVA Flips)를 CSV로 내보낼 수 있습니다.
4. Gauge R&R 측정 시스템 분석
측정된 산포는 칩 자체의 차이와 측정 시스템(테스터 · 프로브 · 소켓 · 방법)의 흔들림이 합쳐진 결과입니다:
측정 오차가 크면 양품을 불량으로, 불량을 양품으로 잘못 판정할 수 있습니다. Gauge R&R 화면은 동일 웨이퍼를 여러 번 측정한 STDF 파일들로 이러한 측정 변동(산포)을 체계적으로 분해합니다. 각 다이를 (X, Y) 좌표 기반으로 자동 정렬·매칭하기 때문에 파일마다 Lot / Wafer ID가 달라도 동일 웨이퍼라면 반복 측정 데이터로 정확히 취급합니다.
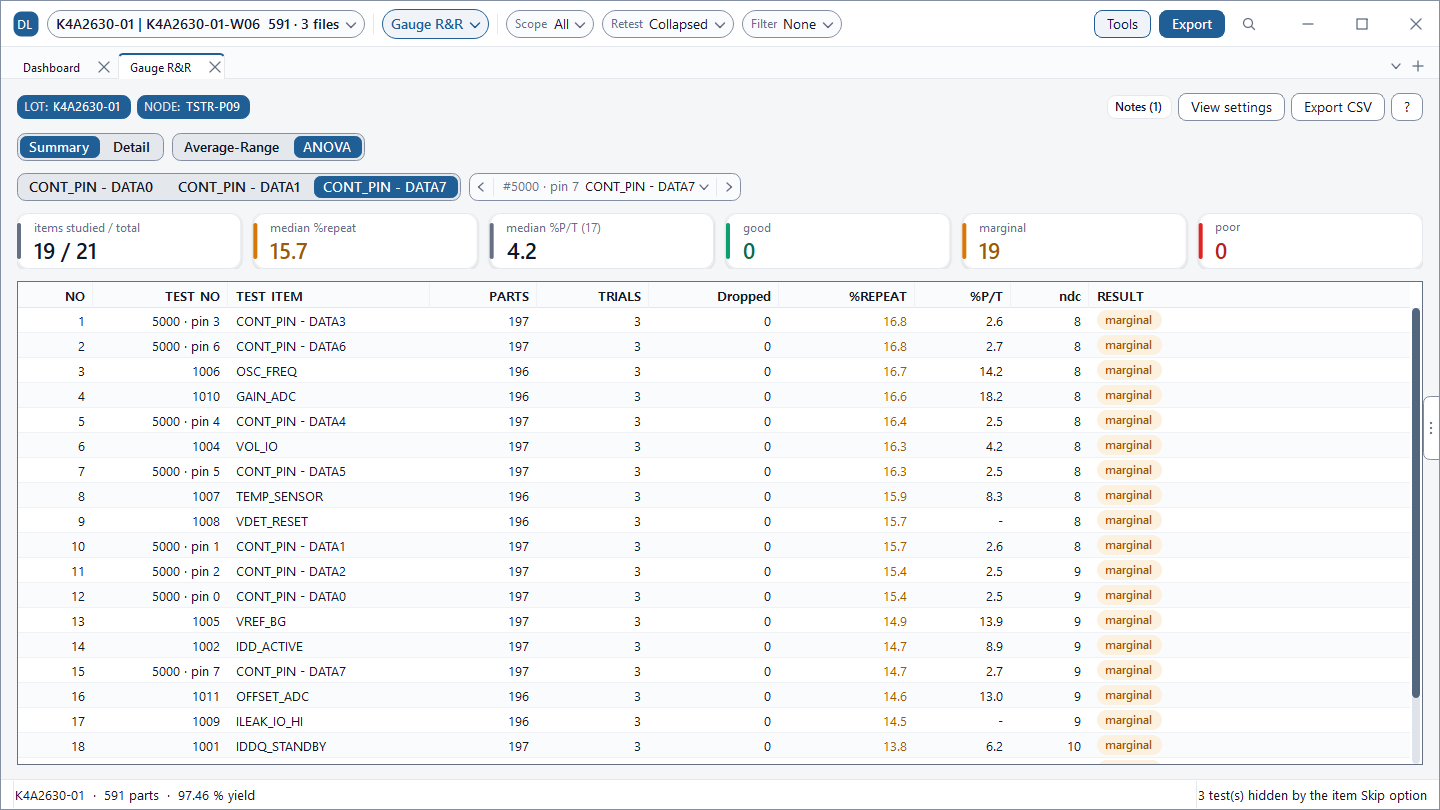 클릭하여 확대
분산 성분과 계산 방법
| 성분 | 의미 |
|---|---|
| EV (반복성) Equipment Variation | 같은 조건에서 반복 측정할 때의 흔들림 (측정기 자체의 노이즈) |
| AV (재현성) Appraiser Variation | 작업자(DLOG에서는 파일 또는 사이트)가 달라질 때의 흔들림 |
| GRR | $\sqrt{EV^2 + AV^2}$ — 측정 시스템 전체가 만드는 변동 |
| PV | 칩 자체의 차이 (실제 공정 변동) |
계산 방법은 ANOVA(기본, 분산 성분을 평균제곱에서 추정)와 Average-Range(AIAG 워크시트 방식, 범위와 $d_2$ 계수 사용)에서 고를 수 있습니다. 파트 수가 많은 연구는 ANOVA가 안정적입니다. 분석 종류는 두 가지입니다. 반복성만(사이트 1개)은 AV를 평가하지 않고, 교차 사이트는 같은 다이를 모든 사이트가 측정했을 때 사이트를 작업자처럼 취급합니다.
%GRR 판정 기준과 ndc
| %GRR | 판정 | 해석 |
|---|---|---|
| 10% 미만 | good | 측정 시스템이 우수합니다. ndc 5 이상이면 분해능도 충분합니다. |
| 10% ~ 30% | marginal | 조건부 수용. 테스트의 중요도와 개선 비용을 고려해 판단합니다. |
| 30% 초과 | poor | 측정 오차가 합부를 좌우할 수 있습니다. 접촉(프로브 · 소켓)과 DIB 노이즈 같은 측정 환경부터 점검하세요. |
5. 사이트 간 편차 분석
멀티사이트 테스트에서는 프로브카드 핀 압력, 소켓 접촉 저항, 릴레이 상태 차이 때문에 특정 사이트만 한쪽으로 치우치는 일이 생깁니다. SITE 화면은 사이트별 수율 · BIN 구성 · 측정값 평균을 비교해 한 사이트만 이상한 경우를 빠르게 찾습니다.
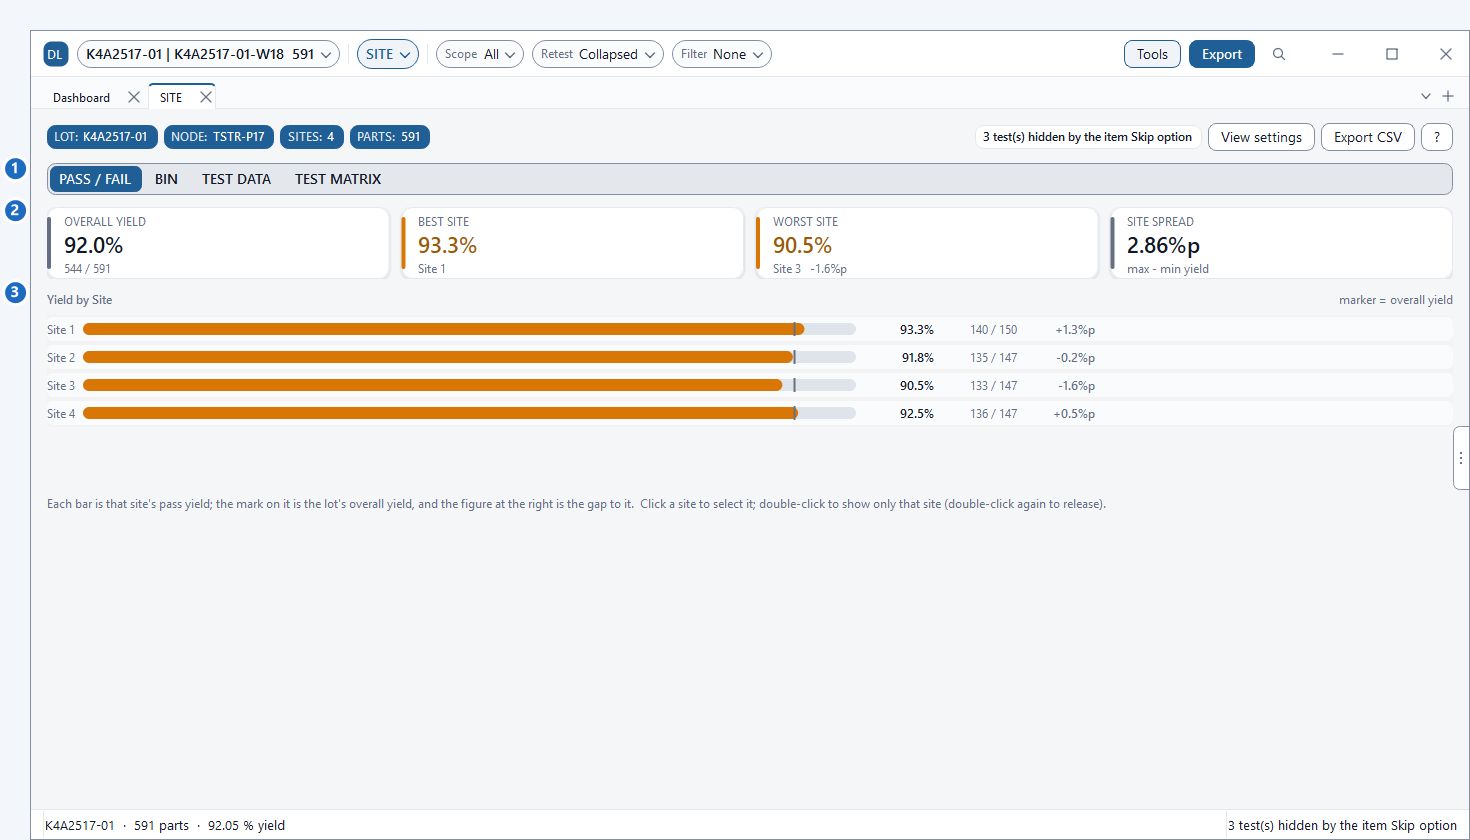 클릭하여 확대
| 확인할 것 | 화면 | 보는 법 |
|---|---|---|
| 수율이 낮은 사이트 | SITE > PASS / FAIL | 가장 짧은 막대. WORST SITE 카드에도 표시 |
| 특정 불량이 몰린 사이트 | SITE > BIN | 그 사이트에 특정 Fail BIN이 집중됐는지 |
| 값이 치우친 사이트 | SITE > TEST DATA | 사이트별 PASS 다이 평균이 전체 평균과 얼마나 다른지(Δ vs overall) |
| 사이트 영향이 큰 테스트 | SITE > TEST MATRIX | η²(전체 흩어짐 중 사이트 차이가 설명하는 비율). 5% 미만이면 사이트 영향이 작다고 보고 Worst Site 칸을 -로 둠 |
| 통계적으로 유의한지 | Group Analysis (Group by: Site) | One-way ANOVA의 p-value, Tukey HSD |
| 사이트 간 측정 재현성 | Gauge R&R (교차 사이트) | 같은 다이를 모든 사이트가 측정했을 때 AV로 평가 |
6. Cpk · Cp · Est ppm · 정규성
공정능력 지수는 스펙 한계(LL/HL) 대비 실제 산포가 얼마나 여유 있는지를 나타냅니다. DLOG는 Chart의 Test Item Statistics와 Tests (Cpk) 목록, Dashboard의 Capability 요약에서 Cpk와 Cp를 보여 줍니다.
$\mu$와 $\sigma$는 현재 선택한 범위(Scope)에 포함된 샘플 전체의 평균과 표본 표준편차이고, Est ppm은 정규분포를 가정한 양쪽 꼬리 확률입니다. 한계가 한쪽뿐이면 그쪽만 계산합니다. Dashboard의 Capability 등급은 기본적으로 Cpk 1.00 미만이면 Critical, 1.33 이상이면 Good, 그 사이는 Marginal이며 이 기준은 설정에서 바꿀 수 있습니다.
| Cpk | 시그마 수준 | 정규 가정 양측 불량률 | 참고 |
|---|---|---|---|
1.00 | $3\sigma$ | 약 2,700 ppm | 평균이 중앙일 때 한계까지 3σ |
1.33 | $4\sigma$ | 약 63 ppm | 일반 산업에서 흔한 합격선 |
1.50 | $4.5\sigma$ | 약 6.8 ppm | |
1.67 | $5\sigma$ | 약 0.57 ppm | 자동차 등 높은 신뢰성 요구에서 자주 쓰는 기준 |
2.00 | $6\sigma$ | 약 0.002 ppm |
위 표는 평균이 한계 중앙에 있고 데이터가 정규분포를 따를 때의 이론값입니다. 요구 기준은 고객과 제품마다 다르므로 계약 · 규격의 기준을 따르세요.
정규성 검정과 CDF / Probability
Cpk와 Est ppm은 데이터가 정규분포라는 전제 위에서만 믿을 수 있습니다. DLOG는 꼬리 부분의 어긋남에 민감한 Anderson-Darling 검정의 p-value를 Normality (AD)로 표시합니다. 보통 p < 0.05이면 정규분포가 아니라고 봅니다.
 클릭하여 확대
7. 상관분석 · ANOVA · TTO
불량 원인은 단일 파라미터가 아니라 여러 테스트의 상호작용이나 특정 그룹(사이트 · 온도 · 로트 · 파일)에서 드러나는 경우가 많습니다. Correlation은 테스트들이 함께 움직이는 정도를, Group Analysis는 그룹 간 평균 차이가 우연이 아닌지를 보여 줍니다.
 클릭하여 확대
 클릭하여 확대
피어슨(Pearson) 및 스피어만(Spearman) 상관
Pearson(기본)은 직선 관계의 강도를, Spearman은 순위 기반이라 이상치에 덜 민감하고 직선이 아닌 단조 관계도 잡아냅니다. Cluster 정렬을 쓰면 상관이 높은 테스트끼리 이웃하게 배치되어 블록이 드러납니다. Parameters의 Auto는 |r| ≥ 0.70인 강한 상관에 참여하는 테스트만 골라 줍니다.
일원분산분석 (One-way ANOVA)
Group Analysis는 테스트 하나를 Site · File · Corner · Temp · Process · Node · Program-Rev · Product 기준으로 나눠 그룹 평균에 통계적으로 의미 있는 차이가 있는지 계산합니다:
- p-value < 0.05: 그룹 평균이 모두 같다면 지금 같은 차이가 우연히 나올 확률이 5% 미만입니다. 적어도 한 그룹은 평균이 다르다고 봅니다.
- Eta² (η²): 값의 흩어짐 중 그룹 차이가 설명하는 비율입니다. 0에 가까우면 그룹 차이가 거의 없고, 0.40이면 흩어짐의 40%가 그룹 차이에서 나옵니다.
- Tukey HSD: 그룹 쌍을 하나씩 비교해 차이가 있는 쌍의 수를 알려 줍니다(예: "0 of 6 pairs differ").
그림 7-2의 예는 Eta² 0.001, p-value 0.6772로 사이트 간 차이가 없는 경우입니다. 위쪽의 초록 칩 No difference가 같은 결론을 알려 줍니다.
8. 공정 이상 vs 측정 이상 가르기
Cpk가 떨어지거나 수율이 내려가면 공정 쪽은 테스터를, 테스트 쪽은 웨이퍼 공정을 의심하기 쉽습니다. 위의 화면들을 조합하면 두 원인을 근거를 가지고 나눌 수 있습니다. 아래는 일반적인 경향이며 최종 판단은 데이터로 확인하세요.
| 확인 항목 | 공정(Fab) 쪽 원인일 때 | 테스터 · 측정 쪽 원인일 때 |
|---|---|---|
| 웨이퍼 공간 분포 (Wafer > Signature) |
링, 가장자리, 중앙, 국소 클러스터 같은 공간 패턴 | 수율은 낮은데 Cluster 점수가 0에 가까움(무작위). 샷이나 사이트 주기성 |
| 사이트 편차 (SITE, Group Analysis) |
모든 사이트에서 비슷하게 나타남 | 특정 사이트만 한쪽으로 치우치고 Group ANOVA가 유의 |
| 측정 신뢰도 (Gauge R&R) |
%GRR이 낮고 PV(칩 간 차이)가 지배적 | %GRR이 높고 EV 또는 AV가 지배적 |
| 측정 순서 추세 (Chart > Trend) |
웨이퍼 · 로트 단위로 단계적 변화 | 측정 순서에 따라 서서히 드리프트, 카드 · 소켓 정비 시점 전후로 변화 |
| 조치 | 공정 장비와 레시피 점검(노광, 식각, CMP 등) | 프로브카드 · 소켓 청소 또는 교체, 접촉과 DIB 노이즈 점검 |
9. 자주 묻는 질문 & 리포트
자주 묻는 질문 (FAQ)
Cpk는 한 테스트의 정규분포를 전제로 합니다. 데이터가 비정규이거나(바이모달 등), 각 테스트는 스펙 안이지만 테스트 간 조합이 평소와 다른 파트는 Cpk가 잡지 못합니다. PAT+(DPAT · SPAT)와 MVA(MVA Explorer, Wafer의 MVA-PAT)를 함께 써서 합격 속 의심 파트를 걸러 보세요.
Gauge R&R의 Detail에서 분산 성분을 확인하세요. 일반적으로 EV가 지배적이면 측정기 자체의 노이즈(접지, 전원 리플, 쉴딩)를, AV가 지배적이면 파일 또는 사이트 간 차이(소켓 접촉, 장착 편차, 캘리브레이션)를 우선 점검합니다.
같은 웨이퍼를 2회 이상 측정한 STDF 파일이 최소 2개 필요하고, 다이 좌표(X, Y)가 있어야 합니다. 재측정 파일은 Append...로 추가하세요. 좌표 없는 파이널 테스트 데이터는 사용할 수 없습니다.
네. 각 화면의 Export CSV로 해당 분석을 CSV로 저장할 수 있고, Export > Save Report에서 PDF · Excel(.xlsx) · Word(.docx) · 이미지 리포트를 만들 수 있습니다. PAT 한계 차트는 PAT (PDF)로 테스트 항목마다 1쪽씩 출력됩니다.
DLOG로 공정능력과 측정 신뢰도를 직접 확인해 보세요
PAT+ 이상치 선별, MVA 탐색, Gauge R&R, 사이트 분석, Cpk 통계까지.
완전 오프라인 환경에서 STDF 심층 분석을 6개월간 무료로 경험해 보세요.